42.3 对 31.2——把这两个数并排放着,2026 年 10 月 17 日那次 DeepSeek 更新的分量就有了底。前一个数是新模型 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 4.0 上的得分,后一个数属于上一版 V4.1 Flash,两数同出自官方更新日志 2026-10-17 的条目。这一天,官方网页端、App 与 API 的模型同步切换,API 的调用方式与价格保持不变,模型名仍写 deepseek-flash(IT之家 2026-10-17 报道与之互为印证)。跑分涨了三分之一还多,但这未必是这批动作里最值钱的部分——同一批放出来的,还有一份新的价目:网页搜索与抓取按每千次成功请求 5 元计费,经由官方 Agent 工具内置调用的部分,从北京时间 2026 年 11 月 1 日 0 时起开始计费。
Token 省下来了,能信几成?
先把官方印在更新日志里的表述抄全。相比上一版,新模型在各基准测试中取得显著提升,「同时缩短了模型的任务运行时间与输出长度,让用户能够以更低成本、更快速度完成任务」,在多个 Harness 框架下达到新的性能-费用帕累托最优;DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 三个框架得到专项优化,官方建议把 Harness 升级到 0.2.1-rc.1 及以上版本。红星新闻 2026-10-18 的转述与此逐句一致。
基准分是成体系地涨:ProgramBench 从 20.3 到 29.1,Automation-Bench 从 54.8 到 60.5,Agents’ Last Exam 从 31.8 到 35.4,DeepSWE v1.1 从 74.2 到 77.0,HLE(不带工具)从 36.8 到 42.6。横向看,网易号「阿鑫讲ai」2026-10-17 的对照整理给出:Terminal-Bench 4.0 上,1017 版的 42.3 高于 GLM 5.3 的 37.9 与 Kimi K3 的 12.6,作者同时提醒,K3 那个反常低分可能与 Claude Code 框架的适配有关;DeepSWE 上 77.0 越过 GPT 5.6-Sol 的 73.0 与 Claude Opus 5 的 74.0,而 Terminal-Bench 上 Claude Opus 5 的 51.8 仍在前面。榜单不同、框架不同,名次就会换一组,读分数要连框架一起读。
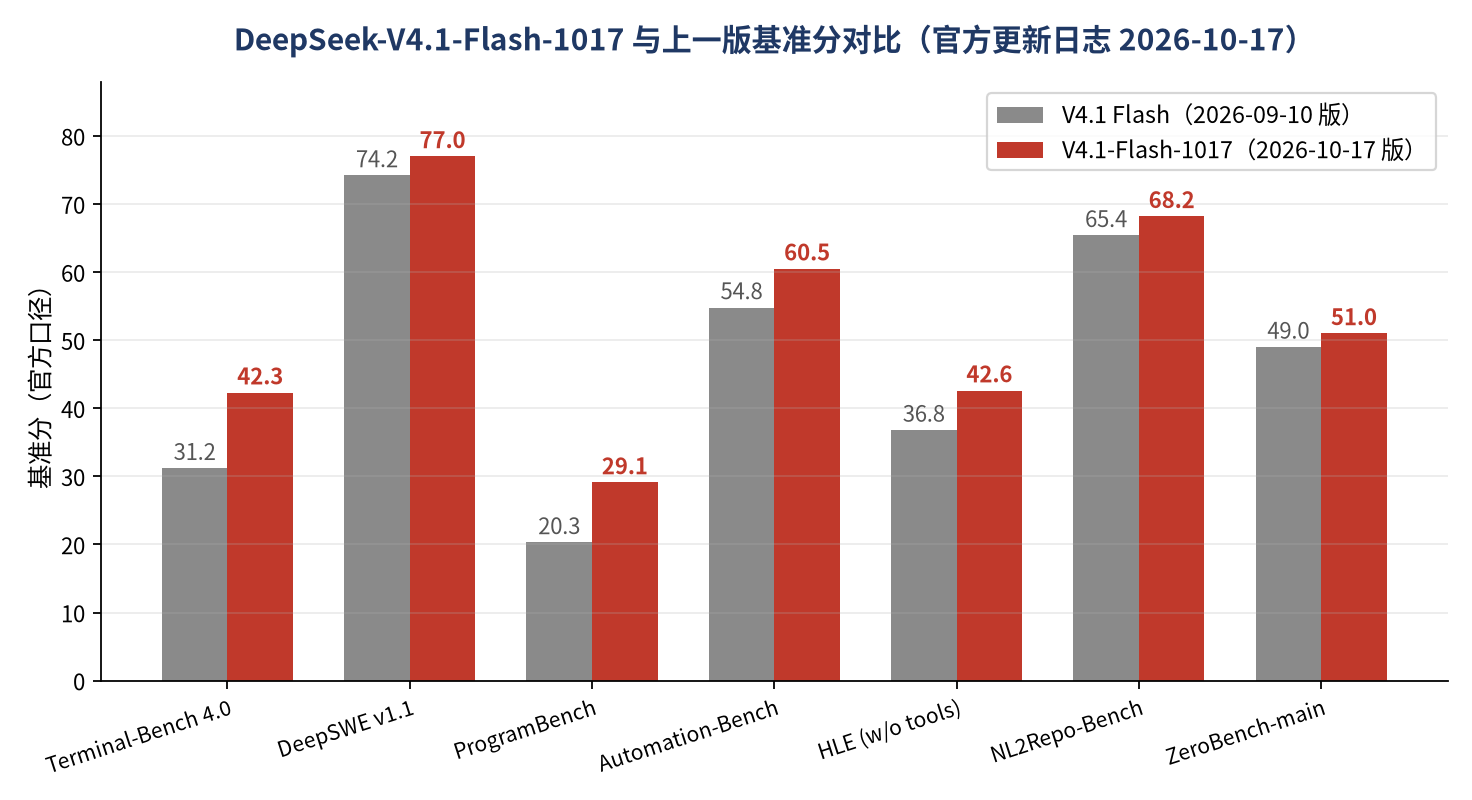
DeepSeek-V4.1-Flash-1017 与上一版 V4.1 Flash 在七项官方基准上的得分对比
来源:自产;数据来源:DeepSeek 官方更新日志 2026-10-17 条目
「Token消耗降超五成」这句流传的概括,官方文件的表述比它保守。官方印着的量化数字,是成体系的基准分数与一整张价目表;输出长度与任务运行时间的缩短,官方以定性表述给出。五成这个量级,出自第三方对官方 DeepSWE 性能-费用曲线图的换算;钱江晚报 2026-10-17 引同一张图时,写的也是同方向的定性表述。两处材料的差别,引用五成时要一并交代。
第三方实测补了一个可对照的点。腾讯新闻「AI寒武纪」2026-10-18 的实测里,模型用 HTML 和 three.js 做火星登陆模拟,单次任务约两个半小时,花费约 2 元,消耗约 3900 万 token,生成速度全程约 250 tokens/s;作者的判断是表现接近 Kimi K3 max(后者用时约一个半小时)。需要区分的是,省 token 与省时间是两件事:这个例子省下了输出费用,思考时间却拉长,总耗时反而更多。官方演示的「许愿式编程」落在故宫 3D 建模、网页版赛车游戏、Godot 复刻《传送门2》这类从零搭完整项目的场景上,恰好是把上下文吃得最深的那一类。
长任务一侧,公开记录里已经出现两个坑。网易号「阿鑫讲ai」翻出 GitHub 上状态仍为 open 的 issue #1669:在 Codex Desktop 的长时编码任务中,上下文压缩明明已经成功,模型却多次自行声称「上下文余量不足」提前停工,停工时记录的输入量只占窗口的 44% 到 47%——余量过半,停工理由出自模型自己的推断,而非系统下发的余量数据。同一篇整理引社区测试数据:上下文超过 100K 之后,生成速度降到不足 100 tokens/s,接近 200K 时约 50 tokens/s。这两个坑不动摇「输出变短」的定性结论,却决定省下来的钱够不够抵上等出来的时间。
每千次5元,怎么个算法?
2026 年 10 月 17 日,DeepSeek 把自研搜索引擎的 Search 与 Fetch 两个接口开放成 API。官方的定位写得很足:AI 原生的通用搜索引擎,索引全球千亿级网页,支持多语言,对 SEO 作弊、GEO 操纵和低质 AIGC 设有识别过滤机制。分工上,Search 负责按关键词找资料,支持限定网站、语言和发布时间;Fetch 负责把选中的网页抓成 Markdown 文本,交给模型接着分析(以上见官方更新日志与钱江晚报 2026-10-17 报道)。
价格一行读完:Search 与 Fetch 各按每 1,000 次成功请求 5 元计费,单次半分钱;请求失败、搜索无结果或超时,不收费。折算下来,一次长任务若让 Agent 翻两千个页面,这块新增支出在十元量级,与 token 侧动辄百万计的用量相比不算重。官方价格页同时写明:当前在 DeepSeek Harness、Claude Code 或 Codex 中经 Server 端工具调用访问 Search/Fetch 的部分暂不计费,「将于北京时间 2026 年 11 月 1 日 00:00 起按次收取调用费用」(官方价格页,2026-10-19 查证)。
这一行的分量不在单价,在计费方式的分岔。模型调用按 token 计量,Agent 少想、少说就省钱;抓取按成功次数计量,Agent 多翻一页就多记一笔,两条曲线各自独立:直接调 Search/Fetch API 的按表计费,经 Harness、Claude Code 或 Codex 内置调用的,从 2026 年 11 月 1 日 0 时起并入账单。回看这一年的价格动作,方向是连贯的:2026 年 8 月 17 日 0 时起,DeepSeek 把模型调用改成峰谷定价,闲时半价;2026 年 9 月 10 日 V4.1-Flash 发布时 API 价格同步下调。到 1017 版,token 侧的成本曲线整体向下,数据获取侧则从隐性走向显性——推理越来越便宜,外部信息开始按份计价。
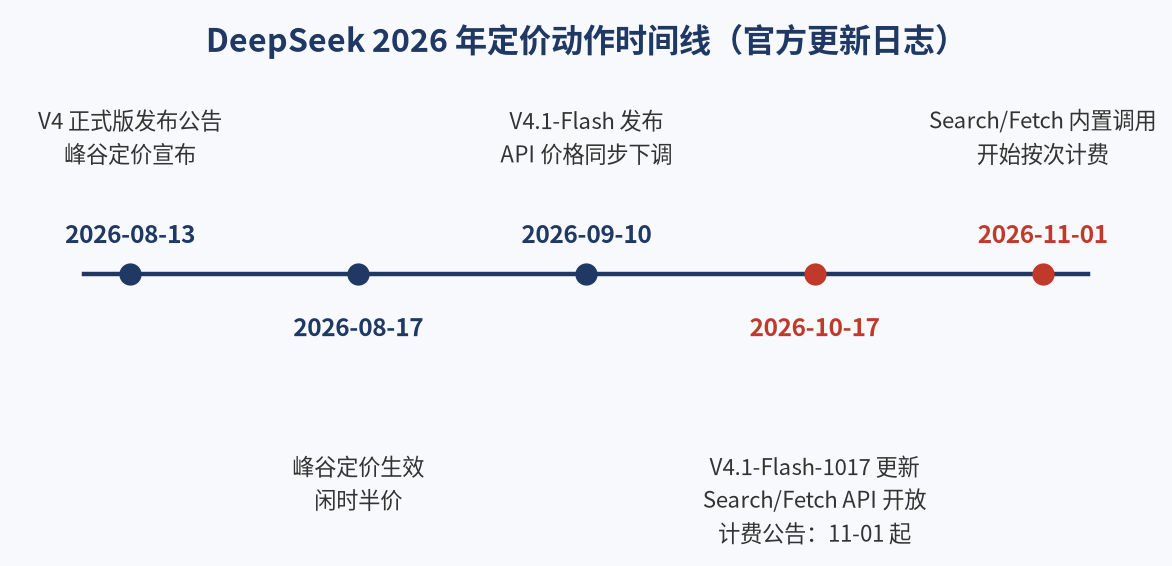
2026 年 8 月至 11 月 DeepSeek 的五个定价节点:峰谷定价宣布与生效、V4.1-Flash 发布、1017 版更新、按次计费起点
来源:自产;数据来源:DeepSeek 官方更新日志
deepseek-flash 当前的档位也值得一并记下:上下文 1M,输出最大 384K,支持思考与非思考两种模式;输入按缓存命中与否分档,缓存命中时空闲时段每百万 token 0.02 元、高峰 0.04 元,未命中为 1 元与 2 元,输出为 4 元与 8 元;高峰时段是北京时间周一至周五的 9:00-12:00 与 14:00-18:00(法定节假日除外),并发限制 2500(以上均出自官方价格页,2026-10-19 查证)。
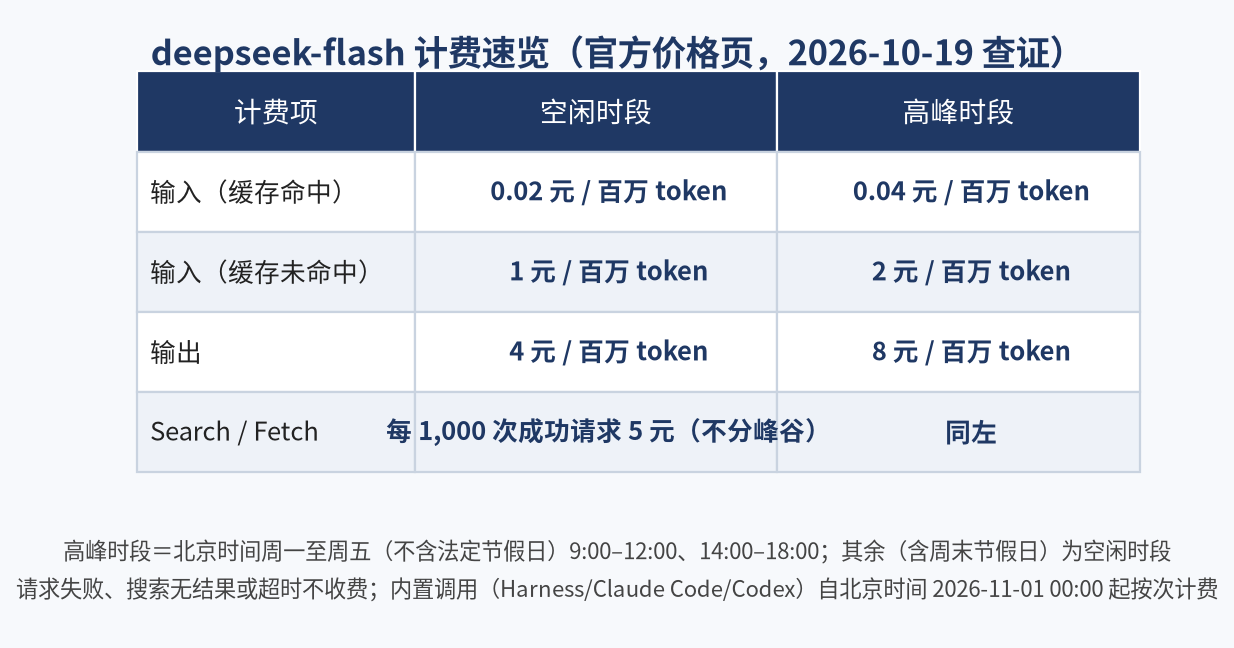
deepseek-flash 计费速览:缓存命中与未命中的输入价格、输出价格,以及 Search/Fetch 按次计费
来源:自产;数据来源:DeepSeek 官方价格页(2026-10-19 查证)
别把基准分当成承诺
官方基准分要用官方给定的框架来读。更新日志注明,Terminal-Bench 4.0 以 Claude Code 框架测试,DeepSWE 用 Mini-SWE-V2 框架,ZeroBench-main 按 Pass@5 评测;换一个框架,名次就可能换一组,「阿鑫讲ai」对 Kimi K3 异常低分保留的意见就是现成的一例。官方自己的措辞是「在多个 Harness 下达到新的性能-费用帕累托最优」——「多个」是有范围的限定词,把它读成所有场景都省一半,就超出了官方承诺的边界。
长期成本的真正下限在开源一侧。IT之家 2026-10-17 报道,模型权重同步放在 HuggingFace 与 ModelScope 上,延续 V4.1 Flash 以 MIT 许可证开源的策略;「AI寒武纪」2026-10-18 也列出了两处权重地址。观察者网 2026 年 4 月对 V4 代的技术拆解给过底盘:V4-Flash 总参数 284B、激活 13B,注意力机制走压缩稀疏与重压缩交替叠用的路线,1M 上下文是全系标配;2026 年 9 月 10 日的更新日志把 V4.1-Flash 描述为该系列里最小的型号,具备原生多模态视觉理解。权重在自己手里,API 价格的涨跌影响的就只是托管成本,而不是还能不能用——这是 DeepSeek 系模型特有的缓冲垫,也是这次降价消息之外更值得放进决策的一项。
可靠性单独记一笔。红星新闻 2026-10-18 报道,2026 年 10 月 15 日上午 DeepSeek 出现服务异常,网页端与 App 无法正常使用,向对话框发消息会看到「服务器暂时不可用」。钱江晚报 2026-10-17 对善后的概括是「先宕机后补偿」,新模型在大周末火速上桌;同篇写到符合条件的用户首次登录 DeepSeek Harness 可领 6 元赠金,无需充值,到账后 7 天内有效,额度限量发放,并把它记作发布时「顺手放的一波福利」,与故障善后分开叙述。
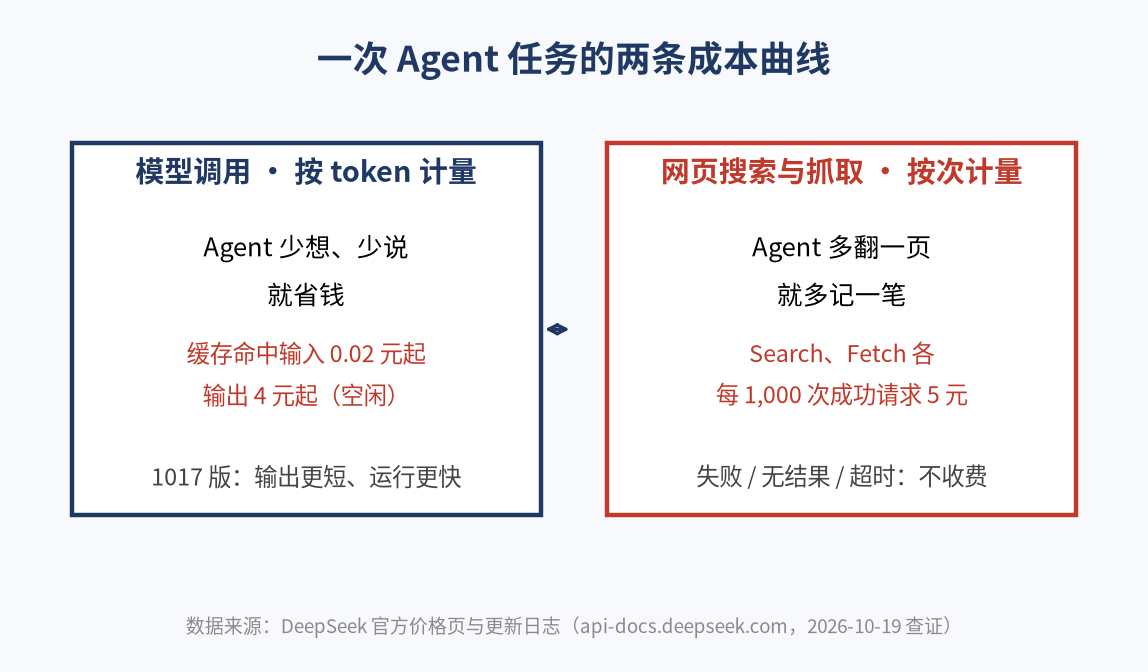
一次 Agent 任务的两条成本曲线:模型调用按 token 计量,网页搜索与抓取按成功次数计量
来源:自产;数据来源:DeepSeek 官方价格页与更新日志
把这些并到一起,结论是:这次更新真正立住的,是「推理更便宜、输出更克制、外部数据按份计价」这条完整的价格线,而不是某一个百分比;五成是一个方向正确的估计值,官方给出的是定性表述与基准分数,两者的差别要在引用时讲明;抓取计费的金额不大,信号却不小,Agent 的成本核算多出一栏:直接调 API 的已按次计费,内置调用的从 2026 年 11 月 1 日 0 时起并入。Search 与 Fetch 的真实用量,在 2026 年 11 月 1 日之前用自己的任务先量一遍,计费后的账单就有基线可比。
顺带交代一件与我有关的安排:承载这一篇的站点,吃流量的图片与静态文件一直放在 挂羊头CDN,这一项在每月账单里小得不起眼。把推理降下来、把数据按份计价,2026 年这一轮定价动作指向同一件事:AI 的成本核算正在从一笔总账变成一本细账,细账比总账诚实,也更容易省。